# Jev e Clef: quando usar modelos de decisão em agentes de IA
Published: 2026-10-04
Author: Gilmar Pupo
Editorial: tecnologia
Content type: article
Canonical: https://www.gpupo.com/posts/modelos-de-decisao/
Tags: Agentes de IA, Arquitetura de software, Inteligência artificial, LLM, Modelos de decisão
---
Um agente que recebe uma mensagem pode precisar escolher uma fila, selecionar
uma ferramenta e decidir se a operação exige aprovação antes de redigir uma
resposta. Essas etapas têm responsabilidades diferentes. Quantas delas estamos
delegando a uma LLM mesmo quando não exigem geração de texto ou raciocínio
aberto?
A [edição 227 da ByteByteGo](https://blog.bytebytego.com/p/ep227-top-9-places-to-use-jev),
publicada em 26 de setembro de 2026, trouxe o Jev, da TypeSafe AI, como exemplo
dessa discussão.
Minha leitura é que a oportunidade vai além do produto: separar a geração de
conteúdo das decisões operacionais que organizam o trabalho de um agente.
Modelos como Jev e Clef são especializados em classificação, pontuação e
escolha entre alternativas definidas pelo programa. A proposta é devolver
diretamente valores que o código possa consumir:
~~~text
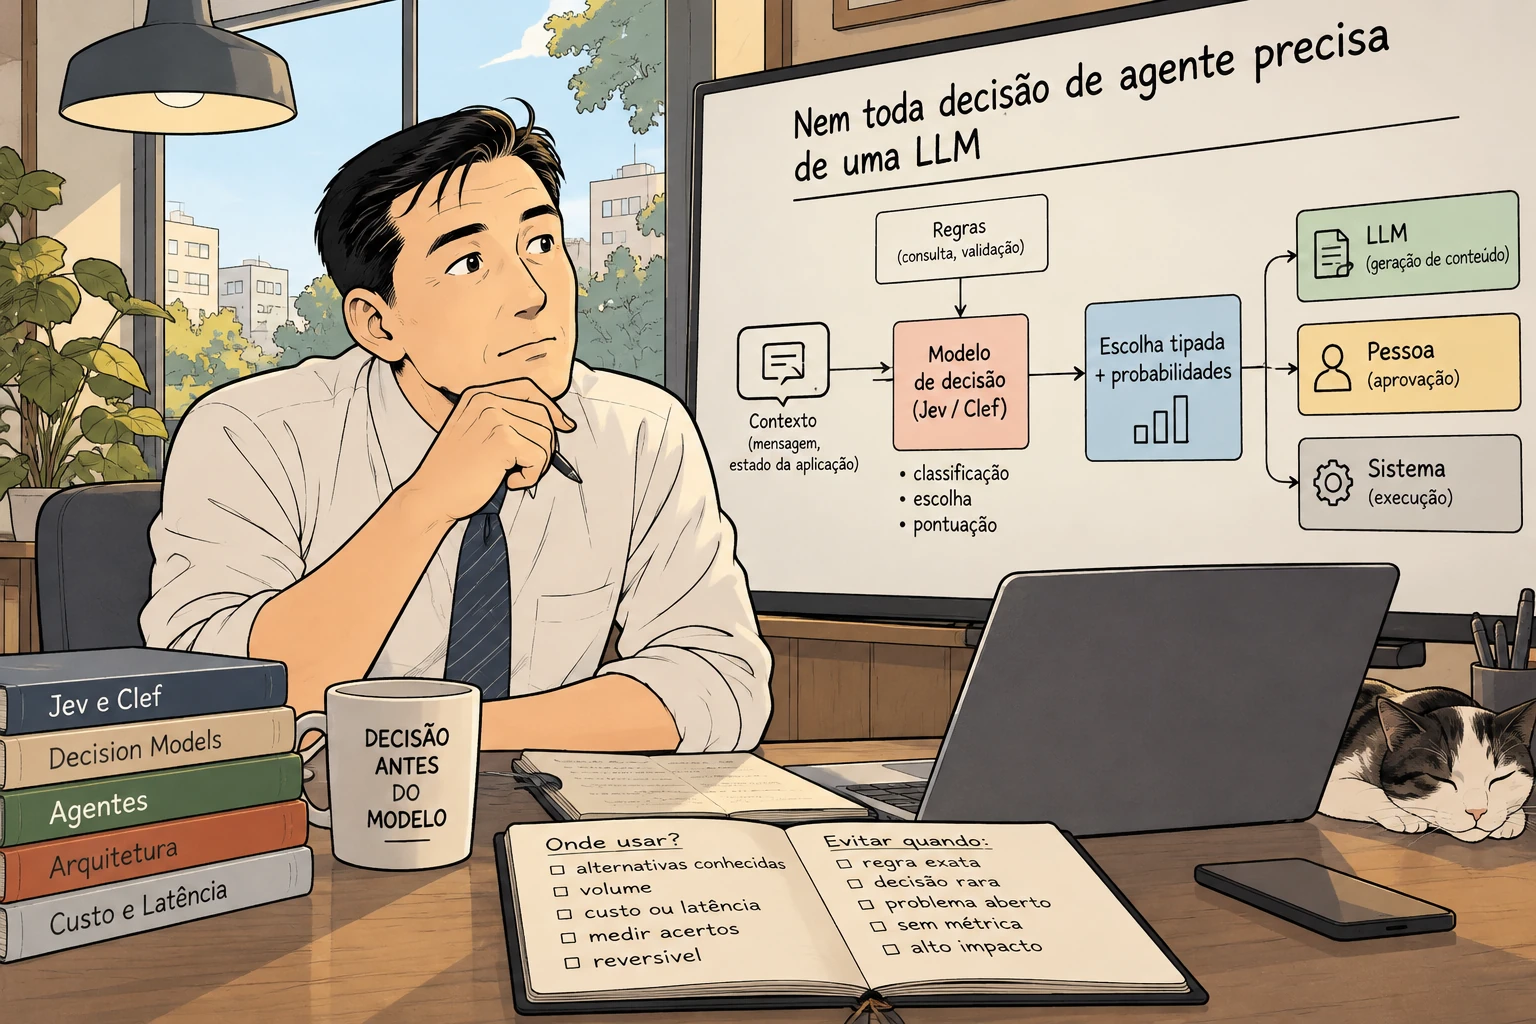
contexto → modelo de decisão → escolha tipada + probabilidades
~~~
Para usar esse tipo de recurso, eu procuraria uma decisão frequente, limitada e mensurável em que essa troca
pudesse reduzir custo ou latência sem aumentar erros.
Regras, modelos de decisão e LLMs no fluxo de um agente. Ilustração criada pelo ChatGPT 6.1 Sol.
## Começar pela decisão, não pelo modelo
Imagine um fluxo de suporte.
Uma mensagem precisa ser classificada por área, urgência e risco. Hoje talvez
ela seja enviada a uma LLM, que lê o texto, explica o que entendeu e devolve um
JSON. Funciona, mas estamos usando uma tecnologia generativa para uma escolha
que o sistema já conhece:
~~~text
área: cobrança | suporte | vendas
urgência: sim | não
risco: baixo | médio | alto
~~~
Esse é um possível caso para um modelo de decisão. A explicação ao cliente, a
investigação de uma cobrança duplicada e a negociação de uma exceção continuam
sendo problemas diferentes.
Podemos separar o fluxo assim:
| trabalho | componente mais provável |
|---|---|
| validar contrato, saldo ou permissão | regra ou consulta determinística |
| classificar área, urgência e risco | modelo de decisão |
| resumir o caso e propor uma resposta | LLM |
| aprovar uma exceção de alto impacto | pessoa responsável |
Consideramos usar o componente quando várias destas condições estiverem presentes:
- a saída pertence a um conjunto conhecido de alternativas;
- a decisão acontece em volume suficiente para custo ou latência importarem;
- as categorias podem mudar e seria caro manter um classificador para cada
nova taxonomia;
- existem exemplos históricos ou outra forma confiável de medir acertos e
erros;
- uma escolha errada pode ser bloqueada, revertida ou encaminhada;
- o sistema já sabe o que fazer quando a confiança é baixa;
- a chamada fica no caminho crítico e alguns segundos fazem diferença.
**Evitamos** começar por:
- obrigações que possam ser expressas como regras exatas;
- decisões raras, nas quais a economia operacional seria irrelevante;
- problemas abertos que exigem investigação ou produção de conteúdo;
- situações sem resultado observável para avaliar o modelo;
- ações irreversíveis ou de alto impacto sem outra barreira de controle.
Também verificaria onde está o gargalo real. Em um exemplo hipotético, reduzir
uma inferência de 500 para 40 milissegundos pode ter pouco efeito se o fluxo
ainda espera quinze minutos por uma aprovação humana.
## O que Jev e Clef oferecem
Em 15 de setembro de 2026, a TypeSafe AI anunciou o
[Jev](https://typesafe.ai/blog/introducing-system-one-models-and-jev), seu
primeiro produto da categoria que chama de **System One Model**. Segundo a
empresa, ele usa uma arquitetura própria e um método de treinamento chamado
**RLCD — Reinforcement Learning for Calibrated Decisions**.
A [documentação do Jev](https://docs.typesafe.ai/introduction) descreve uma API
que recebe o estado da aplicação e perguntas de três tipos:
- noul: a probabilidade de uma afirmação ser verdadeira, entre 0 e 1;
- choice: uma escolha entre alternativas definidas pelo programa;
- score: uma pontuação segundo critérios em uma escala ordenada.
As respostas de choice e score incluem distribuições de
probabilidade e um campo de confiança. O código usa esses valores para
encaminhar o trabalho, aplicar limites ou pedir revisão.
Em 1º de outubro de 2026, a
[Cloudflare anunciou Clef e Clef-flash](https://developers.cloudflare.com/changelog/post/2026-10-01-clef-workers-ai/),
com 27 e 9 bilhões de parâmetros, respectivamente. Os dois têm janela de
contexto de 64 mil tokens. Segundo a empresa, os pesos foram publicados sob
licença Apache 2.0 e os modelos também estão disponíveis no Workers AI.
Um modelo de decisão tenta mudar também o trabalho executado. Em vez de gerar
tokens até formar uma resposta válida, ele é otimizado para avaliar as opções
permitidas e atribuir probabilidades a elas.
~~~text
LLM + Structured Output
↓
modelo generativo restrito a um formato
modelo de decisão
↓
modelo especializado em avaliar opções predefinidas
~~~
## “Zero alucinações” não significa zero decisões erradas
A [TypeSafe usa a expressão “Zero Hallucinations”](https://typesafe.ai/blog/introducing-system-one-models-and-jev)
ao apresentar o Jev. A
garantia técnica descrita pela empresa é mais estreita: como o esquema e as
alternativas são definidos antes da execução, o modelo não produz uma saída
fora desse espaço.
Segurança de tipo evita respostas impossíveis de processar. Não elimina erro de
julgamento, viés, contexto insuficiente, ataque ao conteúdo de entrada ou
mudança no comportamento dos dados.
## Nove lugares para examinar o uso de uma LLM
### 1. Roteamento entre modelos
Um agente pode classificar uma solicitação antes de selecionar o componente
que vai atendê-la: um modelo pequeno, uma LLM com maior capacidade de
raciocínio ou uma função já implementada.
Eu compararia o custo do roteamento com a economia no restante do fluxo.
Encaminhar uma tarefa difícil para um modelo insuficiente pode aumentar as
tentativas e o custo final.
### 2. Guardrails e identificação de riscos
Um classificador pode ajudar a identificar riscos conhecidos em solicitações
ou documentos externos, incluindo possíveis tentativas de *prompt injection*.
Isso seria uma camada adicional de proteção. Conteúdo que passou pela análise
ainda deve ser tratado como entrada não confiável; permissões e restrições de
execução continuam sendo aplicadas pelo sistema.
### 3. Controle de chamadas a ferramentas
Uma chamada pode ser classificada como leitura, escrita, alteração sensível ou
operação que exige confirmação. Consultar um arquivo e excluí-lo, por exemplo,
podem seguir políticas diferentes.
A classificação ajuda a interpretar a intenção. A autorização efetiva deve ser
determinada por regras e permissões explícitas, considerando a ferramenta, os
argumentos e o recurso afetado.
### 4. Triagem de informações
Uma caixa de entrada pode separar mensagens urgentes, comerciais, informativas
ou destinadas ao arquivamento. O mesmo princípio serve para chamados e
documentos.
Eu começaria por categorias com critérios claros e um caminho de correção.
Arquivar uma mensagem urgente tem uma consequência diferente de encaminhá-la
para a fila errada.
### 5. Reranking e seleção de contexto
Em um fluxo de RAG, que recupera documentos para apoiar uma resposta, um
componente pode pontuar a relevância dos resultados. Se a busca retornar vinte
documentos candidatos, o agente poderia selecionar cinco antes da geração.
Selecionar contexto pode evitar o envio de material apenas relacionado ao
assunto. É a distinção que discuto em
[Não crie um agente que saiba a empresa inteira](/posts/nao-crie-um-agente-que-saiba-a-empresa-inteira/):
ter acesso a uma base não exige mantê-la inteira no contexto. Eu verificaria
se o recorte preserva as evidências necessárias e informações que contradizem
a resposta esperada.
### 6. Avaliação de respostas de LLMs
Em determinadas tarefas, um avaliador especializado pode pontuar a resposta de
uma LLM e substituir uma segunda chamada generativa usada como juiz, prática
conhecida como *LLM-as-a-Judge*.
Um resumo poderia ser avaliado quanto à pertinência e à aderência a critérios
previamente definidos.
### 7. Classificação em lote
Categorizar produtos, identificar tipos de documentos ou etiquetar milhares
de eventos são candidatos quando o conjunto de categorias é conhecido.
Além do custo por registro, eu observaria erros recorrentes por categoria.
Uma classificação equivocada repetida em lote pode exigir uma correção maior
do que a economia inicial.
### 8. Decisões em tempo real
Um sistema de monitoramento pode classificar eventos e selecionar rotas de
processamento conforme sua natureza e urgência, reservando análises generativas
para ocorrências selecionadas.
Baixa latência só ajuda se a qualidade atender ao fluxo. Em operações de alto
impacto, a velocidade não elimina controles, validação e fallback.
### 9. Encaminhamento conforme a confiança
Uma classificação com confiança suficiente pode seguir para processamento;
casos ambíguos podem ser encaminhados a uma LLM ou a uma pessoa. Esse mecanismo
é chamado de *confidence gate*.
Eu definiria os limites por tipo de decisão e custo do erro. Uma estimativa
alta, isoladamente, não garante acerto: os limites precisam ser testados nos
dados da aplicação, como discuto adiante.
## Onde eu aplicaria isso na prática
Os nove casos também podem ser combinados em um mesmo fluxo. Estes são alguns
projetos em que eu examinaria essa separação.
### Markdown e Obsidian
Imagine um agente responsável por organizar informações em um cofre de notas
do Obsidian, como no exemplo de
[harness como assistente de anotação](/posts/como-usar-um-harness-como-assistente-de-anotacao/).
Antes de escrever, ele precisa selecionar notas, carregar instruções
aplicáveis e consultar as permissões de alteração dos arquivos.
Um classificador poderia identificar a natureza da solicitação, enquanto um
mecanismo de relevância selecionaria notas. O carregamento das instruções e as
permissões de escrita seguiriam regras explícitas, sem depender da classificação
para serem respeitados.
A LLM entraria para interpretar informações, sintetizar conteúdo ou produzir
um documento. Eu mediria se a seleção reduz chamadas sem omitir contexto
necessário.
### Geração de anúncios
Um agente que produz anúncios de equipamentos usados pode receber tipo,
fabricante, modelo, estado de conservação e preço como dados estruturados.
Antes da redação, o sistema pode:
- verificar campos obrigatórios;
- usar a categoria cadastrada ou classificar uma descrição ambígua;
- identificar venda ou troca a partir dos dados recebidos;
- selecionar o modelo de anúncio;
- encaminhar inconsistências para revisão.
Validação de campos e seleção por categoria explícita podem ser feitas em
código. Um modelo de decisão só teria função quando houver ambiguidade. Depois,
a LLM receberia os dados para propor a redação do anúncio. Os atributos críticos
continuariam vindo da fonte estruturada, e o texto gerado precisaria ser
comparado com ela antes de publicar. É a separação explorada em
[LLM local para descrição de produto: gerar texto sem inventar atributos](/lessons/uso-de-um-llm-pequeno-para-melhoria-de-descricao-de-produto/).
### Documentação técnica
Eu separaria identificação do documento, seleção do template, validação dos
dados e geração do conteúdo.
Se existem três templates bem definidos e a categoria já está cadastrada,
o código pode selecionar o layout e verificar os campos obrigatórios. Um
modelo de decisão pode ajudar a classificar uma entrada ambígua; a LLM fica
responsável pelas partes que exigem elaboração em linguagem natural.
Essa divisão permite testar seleção e validação separadamente da qualidade do
texto gerado.
### Observabilidade e operação
Um fluxo de observabilidade pode combinar regras para condições conhecidas,
classificadores para categorizar eventos e LLMs para analisar ocorrências
selecionadas.
Eu começaria pelo encaminhamento, preservando os eventos originais e os alertas
determinísticos. Antes de permitir descarte automático, verificaria se o
classificador deixa passar ocorrências relevantes e como recuperar uma decisão
errada.
## Nem toda decisão precisa de inteligência artificial
O primeiro filtro é verificar se há algo a inferir. Um campo obrigatório pode
ser validado em código; uma categoria explícita pode selecionar um template.
Essa divisão segue o critério discutido em
[Agent decide, Crew colabora e Flow orquestra sistemas com IA](/posts/agent-crew-flow-nao-sao-a-mesma-coisa/):
identificar a responsabilidade antes de escolher a abstração.
| responsabilidade | quando utilizar |
|---|---|
| código e regras | decisão conhecida, objetiva e determinística |
| modelos de decisão | classificação, pontuação ou escolha limitada com ambiguidade |
| LLMs generativas | interpretação de problemas abertos, planejamento, síntese ou produção de conteúdo |
O Jev não precisa ser o centro da arquitetura. Classificadores tradicionais,
modelos menores e mecanismos de pontuação também são alternativas. Eu
compararia cada componente com a solução mais simples que atende aos
requisitos, incluindo integração, avaliação, observabilidade e manutenção.
Uma arquitetura com vários modelos pode custar menos por execução e exigir
mais trabalho para operar. A escolha depende de volume, latência, precisão e
custo total, não apenas do preço da inferência.
## O modelo participa do fluxo; o código mantém o controle
Eu não colocaria o modelo de decisão no lugar das regras de negócio. Ele
entraria depois das regras exatas e antes dos componentes mais caros ou mais
abertos.
“Alta confiança” não deveria ser uma autorização universal. A política também
precisa considerar impacto, reversibilidade, identidade de quem pediu a ação e
estado atual do sistema.
O pseudocódigo abaixo ilustra uma política de encaminhamento. As funções e os
campos são abstrações da aplicação, não uma reprodução da API do Jev:
~~~python
decision = decision_model.evaluate(context, choices)
if decision.timed_out or not decision.valid:
action = use_safe_fallback()
else:
policy = policies[decision.choice]
if not permissions.allow(actor, decision.choice, resource):
action = deny_action()
elif (
decision.confidence >= policy.auto_threshold
and policy.reversible
and policy.low_risk
):
action = execute(decision.choice)
elif decision.confidence >= policy.analysis_threshold:
action = ask_llm_to_analyze(decision, context)
else:
action = request_human_review(decision, context)
record(decision, action, final_outcome)
~~~
Uma análise adicional da LLM ou uma revisão humana não dispensa a verificação
de permissões na execução posterior. A autorização também precisa ocorrer no
momento de usar a ferramenta, com os argumentos e o estado atuais.
Sem registrar o que o modelo decidiu, qual política foi aplicada e qual foi o
resultado final, não há como avaliar qualidade, investigar incidentes ou
ajustar os limites.
## O caso de negócio precisa incluir os erros
Na [tabela publicada pela Cloudflare](https://blog.cloudflare.com/clef-decision-models/),
os resultados de latência mediana foram:
| modelo | latência mediana |
|---|---:|
| Jev | 524,1 ms |
| Clef | 209,3 ms |
| Clef-flash | **38,8 ms** |
| Laya | 5,8 ms |
A Cloudflare diz ter executado 43 avaliações e observa que o Laya ganhou em
velocidade, mas perdeu qualidade nos testes apresentados. Eu usaria esses
números para formular uma hipótese, não para aprovar uma compra. Foram
publicados por um concorrente e dependem de hardware, rede, carga, dados e
definição de qualidade.
Essa leitura segue a preocupação de
[Um número correto ainda pode contar a história errada em tecnologia](/posts/numeros-nao-mentem/):
a métrica precisa vir acompanhada do cenário e do custo dos erros.
Para o fluxo completo, eu estimaria cada parcela em reais por mês:
~~~text
benefício mensal
= economia com chamadas de LLM
+ economia com trabalho manual
+ valor da redução de latência
- custo do modelo
- custo dos fallbacks
- custo de operação
- custo esperado dos erros
~~~
O custo esperado dos erros faz parte da comparação. Para uma decisão de baixo
impacto, ele pode ser pequeno. Para fraude, crédito, acesso,
saúde, segurança ou movimentação financeira, pode dominar toda a conta.
Além da mediana, eu mediria:
- latência p95 e p99;
- taxa de timeout;
- disponibilidade;
- custo por mil decisões;
- proporção encaminhada à LLM;
- proporção encaminhada a pessoas;
- taxa e custo de falsos positivos e falsos negativos;
- resultado de negócio depois da decisão.
Um modelo mais rápido que transfere casos demais para revisão pode custar mais
no final.
## Probabilidade calibrada precisa funcionar nos nossos dados
Se um modelo binário bem calibrado atribui probabilidade próxima de 0,93 a
muitos casos comparáveis, esperamos que aproximadamente 93% deles pertençam à
classe positiva. A
[documentação de calibração do scikit-learn](https://scikit-learn.org/stable/modules/calibration.html)
usa essa interpretação por frequência.
Isso não quer dizer que uma resposta individual esteja “93% correta”.
Também não quer dizer que a calibração publicada pelo fornecedor continuará
válida para nossos clientes, idiomas, produtos ou padrões de fraude.
Na prática, eu criaria limites diferentes por decisão:
~~~text
ordenar uma fila interna
→ tolerância maior a erro
bloquear uma conta
→ tolerância menor e caminho de contestação
autorizar uma ação irreversível
→ outra verificação ou aprovação humana
~~~
Na [documentação do Jev sobre confiança](https://docs.typesafe.ai/confidence),
confidence é uma estatística derivada da distribuição de
probabilidades. Não é uma probabilidade adicional de acerto. Para
choice, ela considera a maior probabilidade em relação a uma
distribuição uniforme; para score, considera também a distância
entre os níveis.
Eu validaria a relação entre esse campo e os erros observados antes de escolher
limites de automação. Um valor de confiança de 0,93 não significa, por si só,
93% de acertos, e um único limite global pode esconder diferenças entre tarefas.
## Eu implantaria em cinco etapas
### 1. Escolher uma decisão estreita
Começaria por uma única bifurcação com volume, resultado observável e baixo
impacto. “Qual fila recebe este chamado?” é melhor experimento do que “o agente
pode administrar sozinho a operação?”.
Definiria antes do teste:
- quem é responsável pela decisão;
- o que conta como acerto;
- qual erro é mais caro;
- qual é o baseline atual;
- quando o experimento deve ser interrompido.
### 2. Construir uma avaliação interna
Usaria casos históricos representativos, incluindo exceções e períodos
recentes. Compararia o modelo de decisão com o fluxo atual, não apenas com outro
modelo.
Separaria os dados usados para escolher thresholds daqueles usados para a
avaliação final. Também examinaria segmentos com comportamentos diferentes,
como idioma, produto, região, canal ou tipo de cliente.
### 3. Executar em modo sombra
O modelo receberia entradas reais e registraria decisões sem controlar o
resultado. Essa etapa permite medir latência, custo, calibração e divergências
sem expor clientes ao novo fluxo.
Modo sombra não elimina risco de dados. Antes de ativá-lo, ainda é necessário
verificar retenção, residência, acesso, dados pessoais e termos de uso do
fornecedor.
### 4. Automatizar apenas a faixa segura
Depois dos testes, liberaria uma parcela pequena de decisões autorizadas,
reversíveis, de baixo impacto e dentro dos limites de confiança validados. O
restante continuaria no fluxo existente.
Usaria *feature flag*, limite de volume, fallback conhecido e um mecanismo de
desativação imediata. Aumentaria a exposição somente se as métricas de negócio,
risco e operação permanecessem dentro dos limites definidos.
### 5. Monitorar o resultado, não apenas o modelo
Registraria versão do modelo, esquema das perguntas, alternativas oferecidas,
probabilidades, latência, política aplicada, fallback e resultado posterior.
Também acompanharia mudança de distribuição. Uma decisão calibrada no mês do
lançamento pode deixar de ser confiável depois de uma alteração de produto, de
uma campanha comercial ou de uma nova estratégia de ataque.
### Fontes consultadas
- [ByteByteGo — EP227: Top 9 Places to Use Jev](https://blog.bytebytego.com/p/ep227-top-9-places-to-use-jev), publicada em 26 de setembro de 2026
- [TypeSafe AI — Documentação do Jev](https://docs.typesafe.ai/introduction)
- [TypeSafe AI — Confidence](https://docs.typesafe.ai/confidence)
- [TypeSafe AI — Introducing System One Models & Jev](https://typesafe.ai/blog/introducing-system-one-models-and-jev)
- [Cloudflare — Introducing Clef](https://blog.cloudflare.com/clef-decision-models/)
- [Cloudflare Developers — Clef no Workers AI](https://developers.cloudflare.com/changelog/post/2026-10-01-clef-workers-ai/)
- [OpenAI — Introducing Structured Outputs in the API](https://openai.com/index/introducing-structured-outputs-in-the-api/)
- [scikit-learn — Probability calibration](https://scikit-learn.org/stable/modules/calibration.html)